Lux süper bilgisayarı açıldı: 4.032 AMD GPU ile bilimsel araştırmalara güç verecek
Lux süper bilgisayarı, 4.032 AMD MI355X GPU ile bilimsel kullanıma açıldı. Donanımı, TOP500 sonucu ve yapay zekâ araştırmalarındaki rolü.
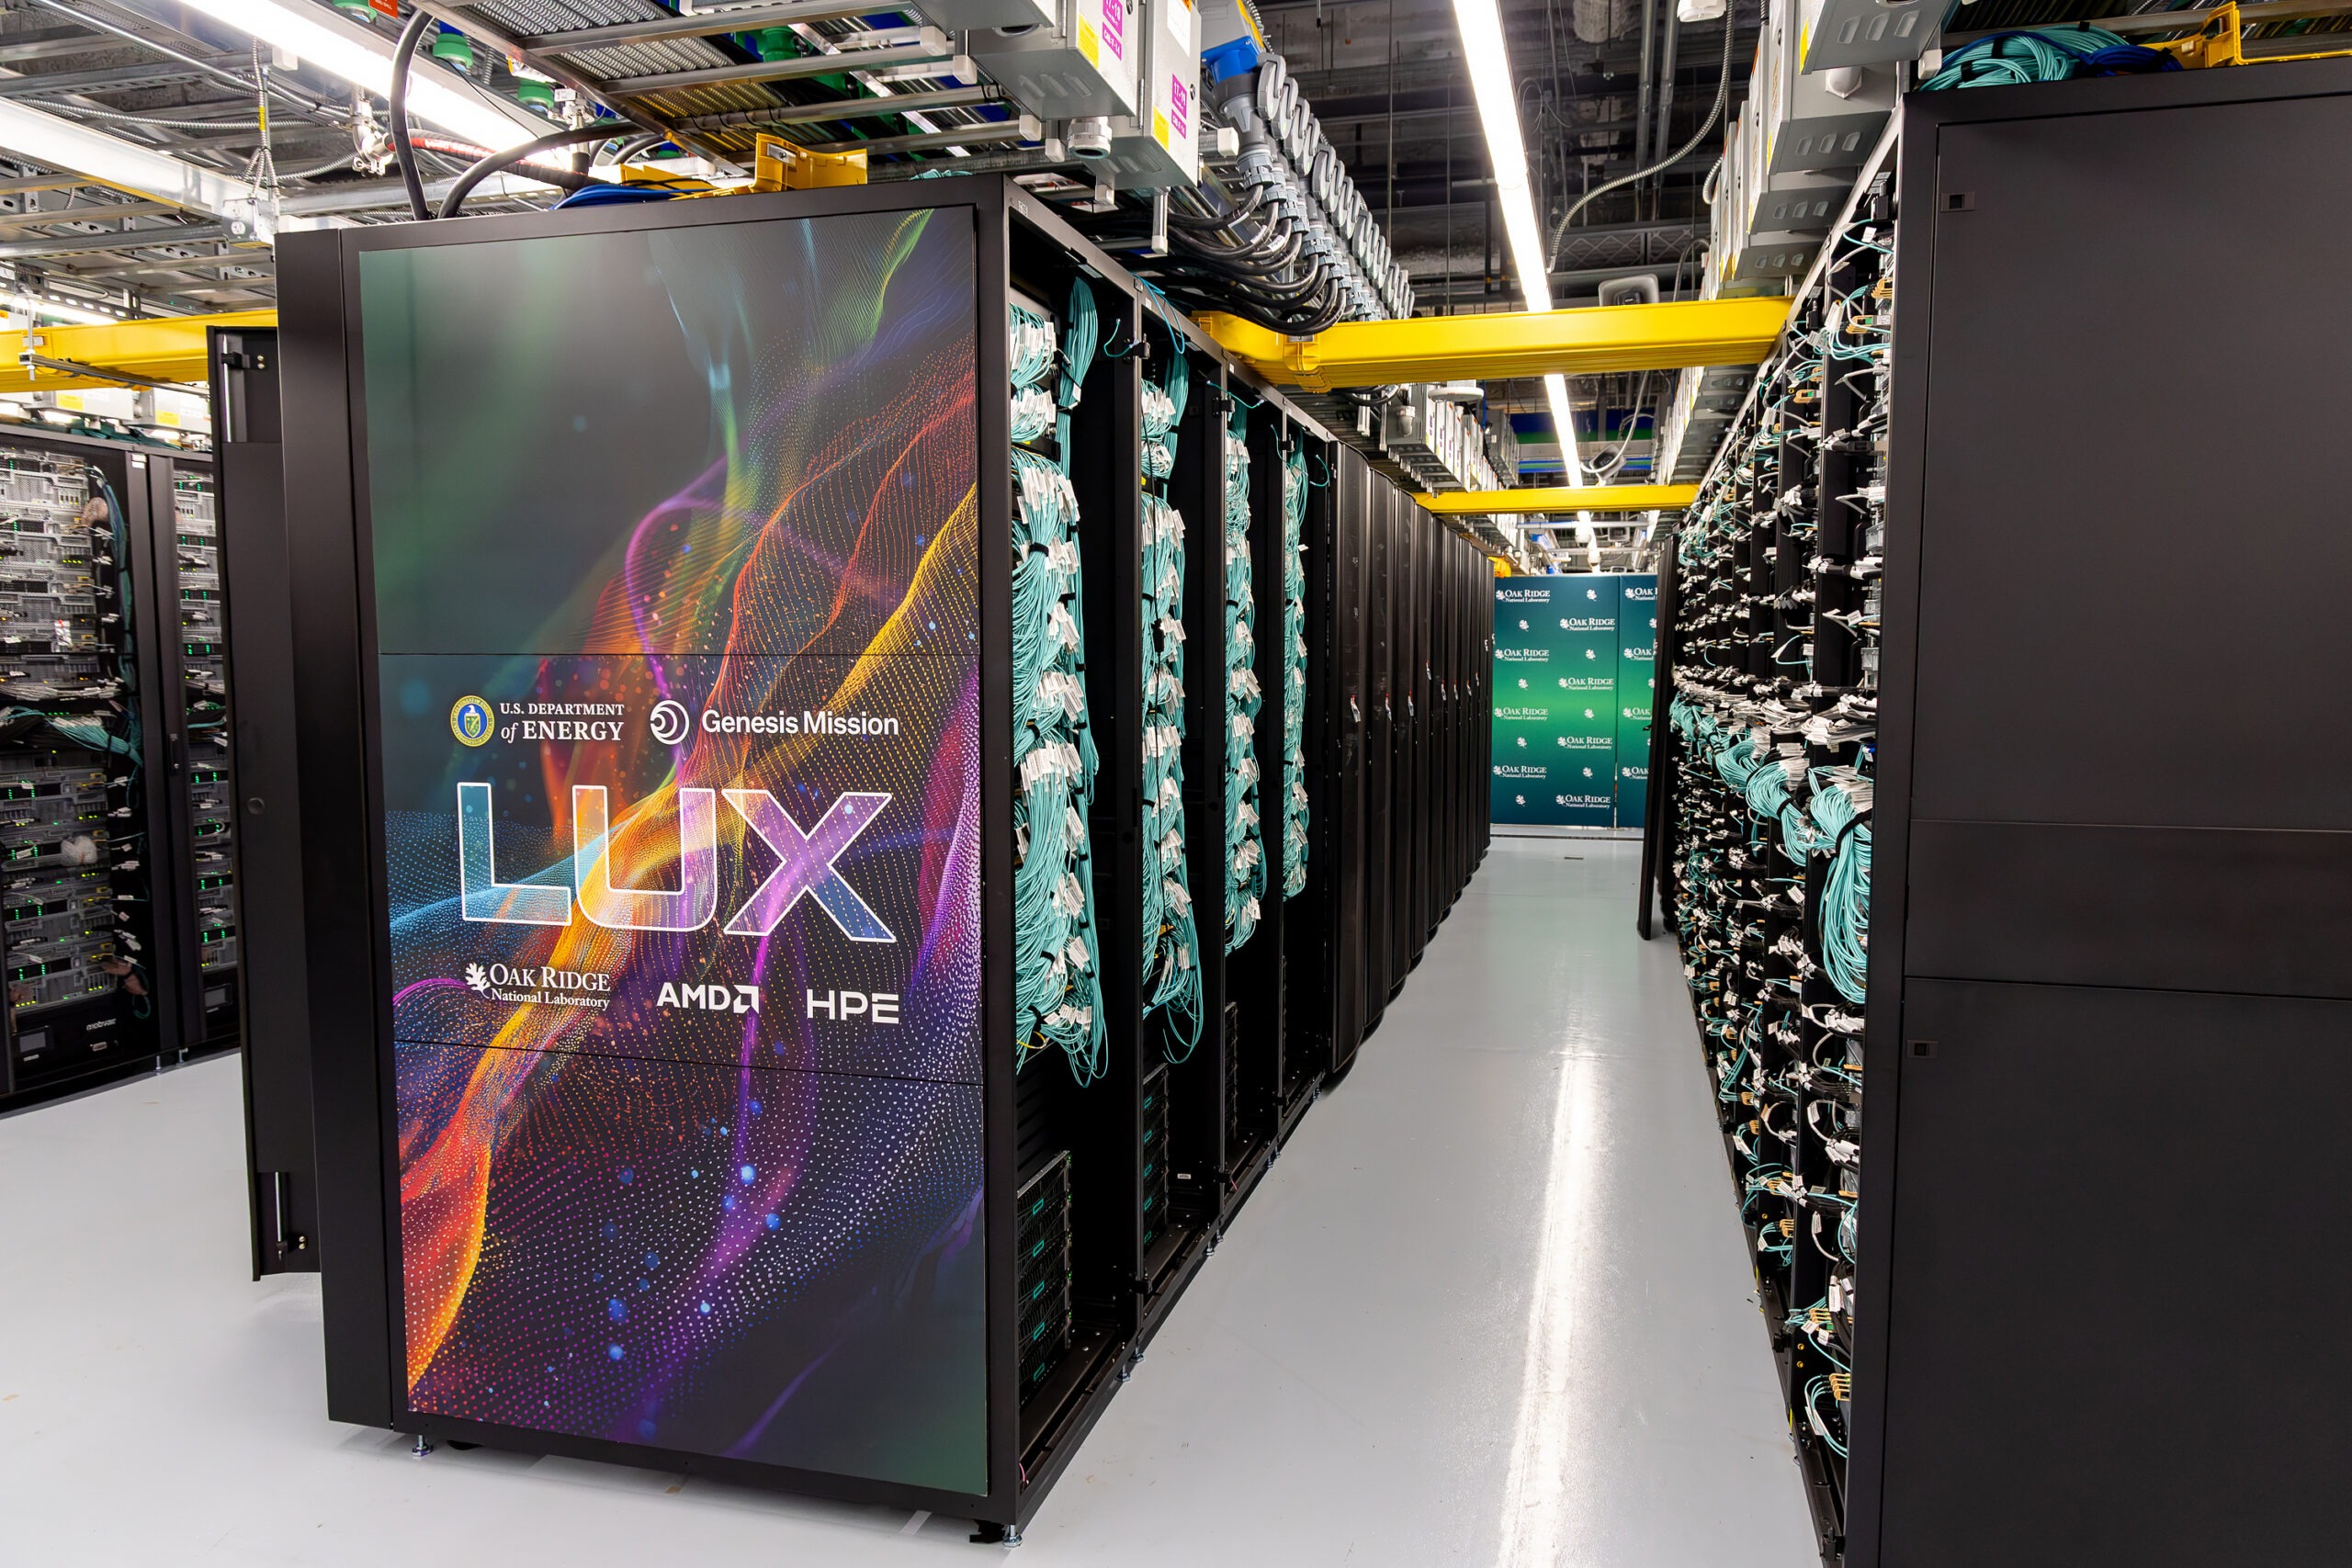
AMD ve HPE teknolojileriyle kurulan Lux süper bilgisayarı, 16 Kasım 2026’da Oak Ridge Ulusal Laboratuvarı’nda bilimsel kullanıcıların erişimine açıldı. ABD Enerji Bakanlığı’nın Genesis Mission girişimi için hazırlanan sistem, TOP500 listesinin 68’inci sürümüne 14’üncü sıradan girdi. Açıklanan 220,79 petaflops sonucu, yeni makinenin yalnızca bir yapay zekâ vitrini olmadığını; geleneksel bilimsel hesaplamalarda da ciddi bir kapasite sunduğunu gösteriyor.
Lux’u ilginç kılan, tek başına sıralamadaki yeri değil. Sistem, binlerce GPU’yu büyük bellek kapasitesi, ortak depolama ve farklı iş yönetim yöntemleriyle birleştiriyor. Amaç; simülasyondan çıkan veriyi yapay zekâ eğitimine, eğitilmiş modeli de yeni bilimsel denemelere taşıyan bir çalışma düzeni oluşturmak. Bu haber ve teknik değerlendirmede Lux’u fiziksel olarak test etmedik; açıklanan yapılandırmayı ve kullanım senaryolarını ele alıyoruz.
Lux’ta yeni olan ne?
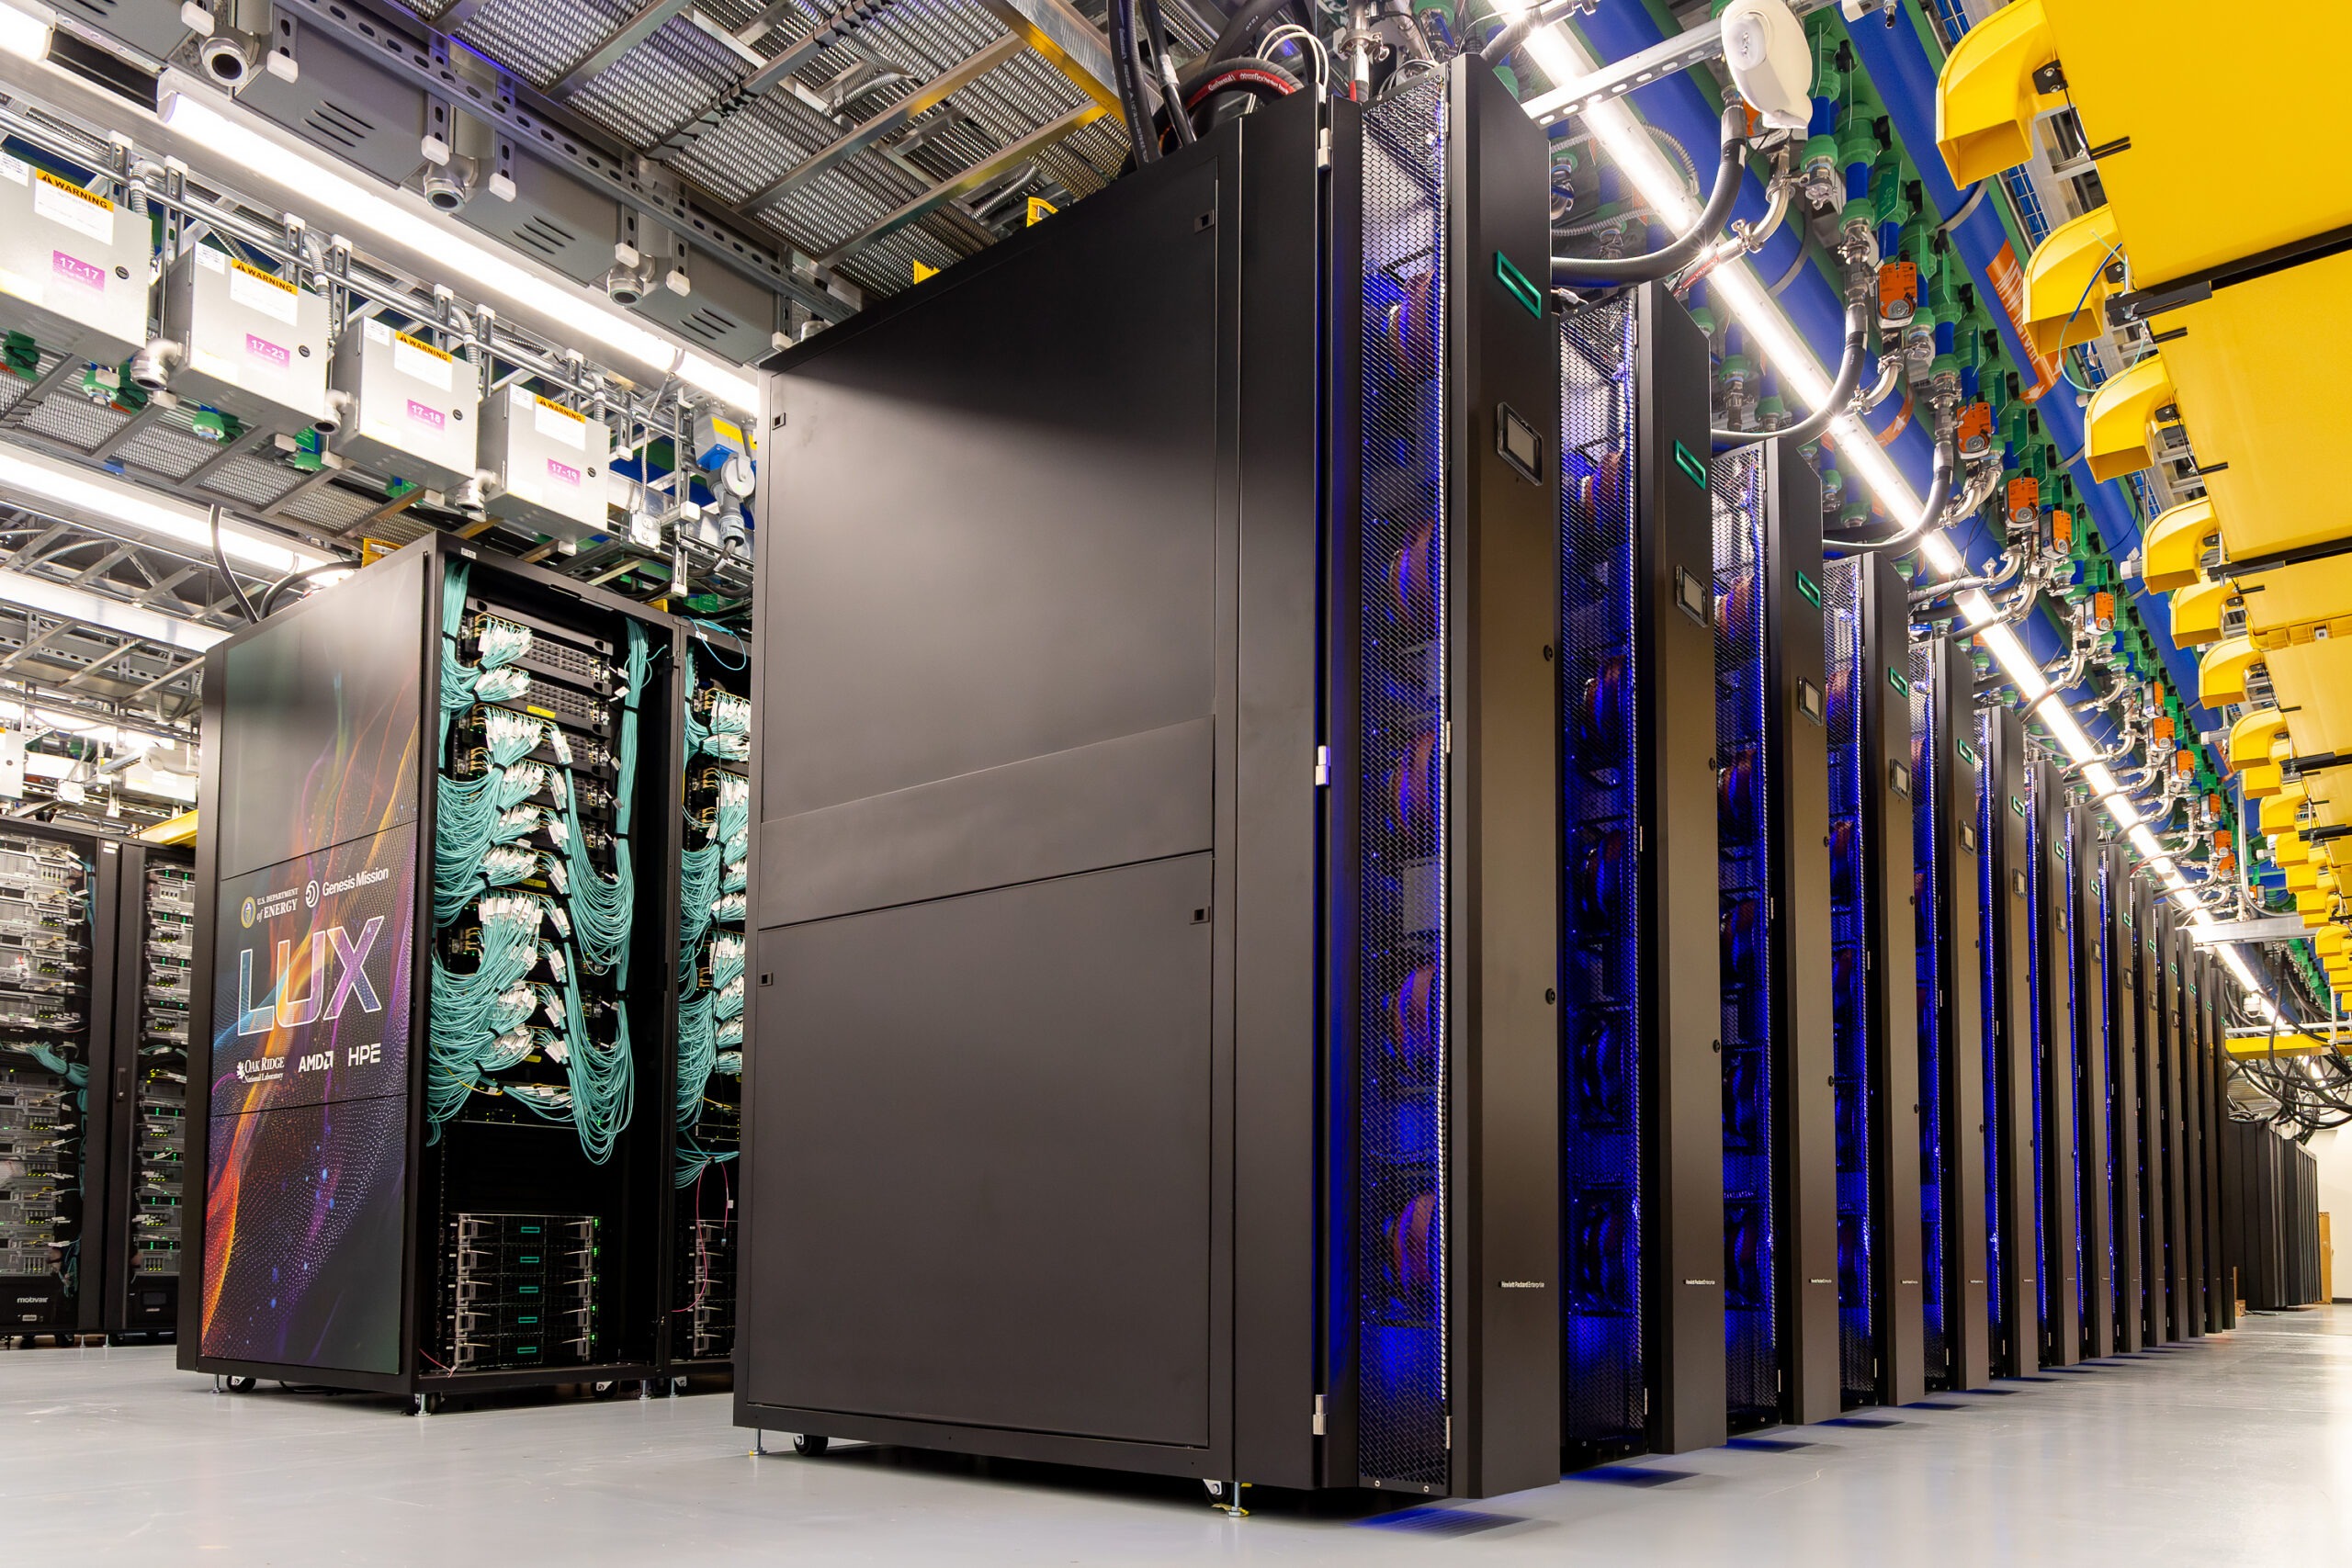
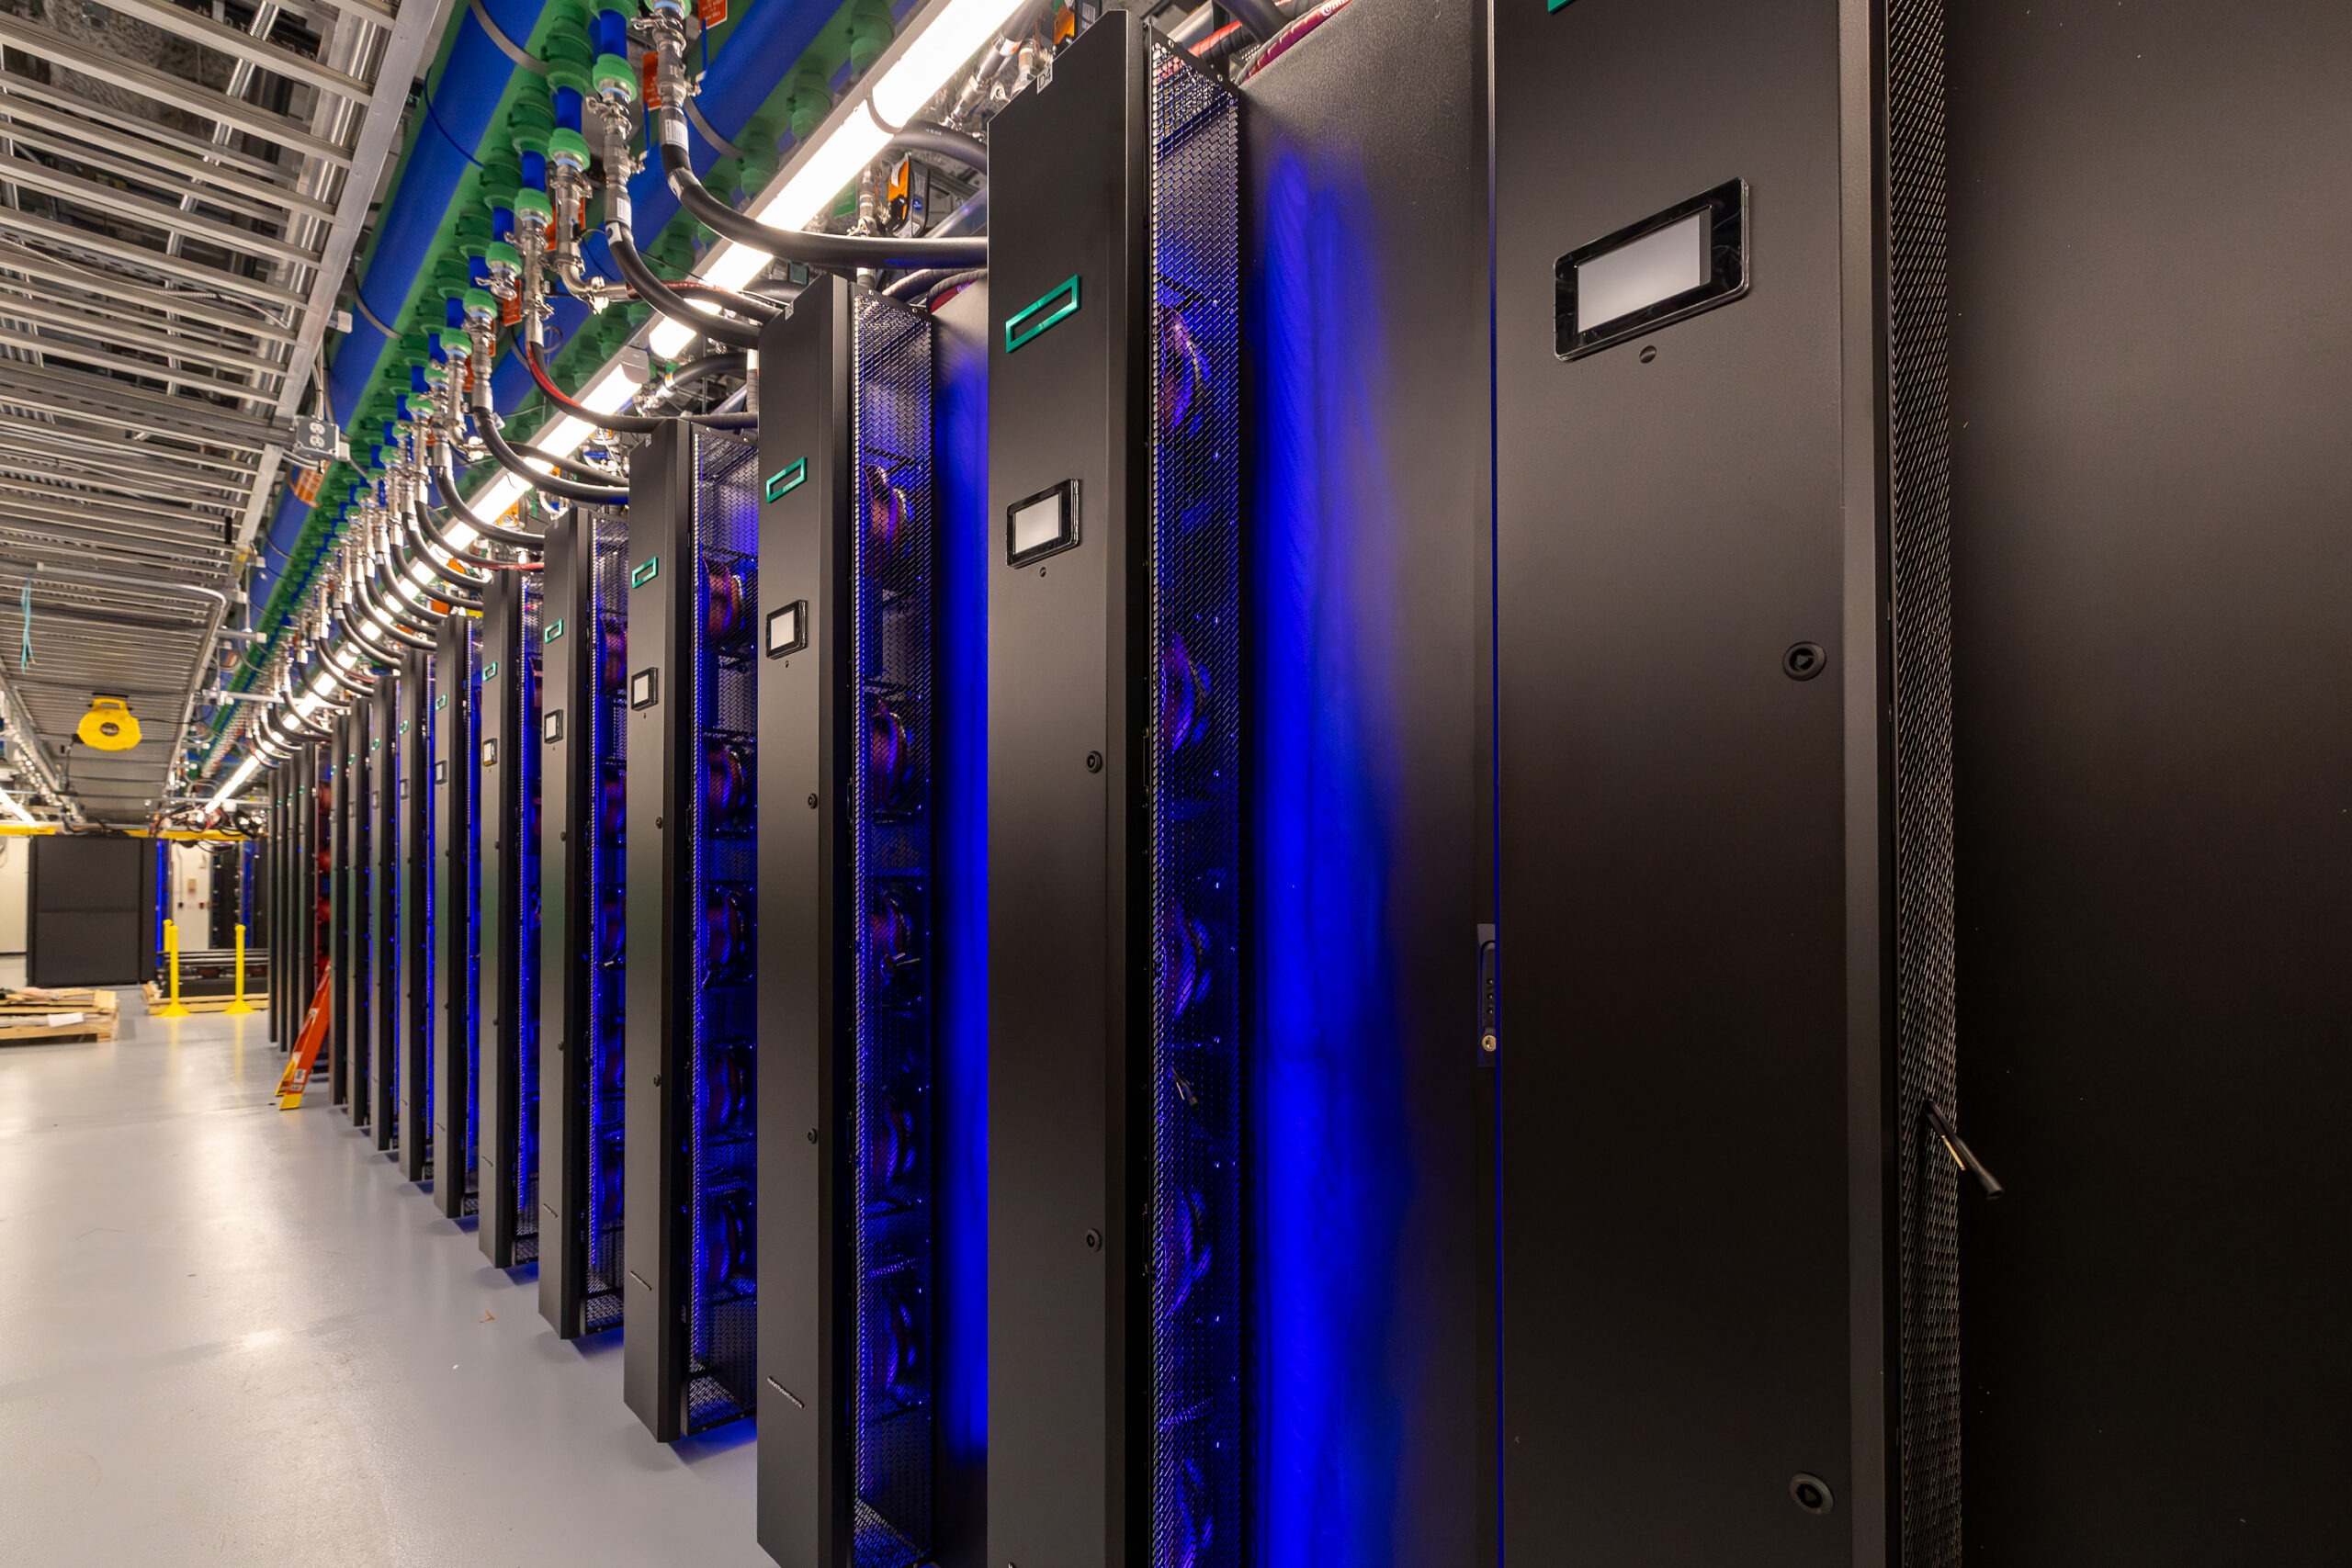
Lux daha önce duyurulmuş bir projeydi. Güncel gelişme, makinenin 16 Kasım’da bilimsel kullanıma açılması ve ölçülmüş performansıyla TOP500 listesinde yer alması. Dolayısıyla burada gelecekte kurulması beklenen bir sistemden değil, kullanıcı kabul etmeye başlayan bir araştırma altyapısından söz ediyoruz. Haberdeki fotoğraflar ise aynı sistemin Temmuz 2026’daki kurulum ve entegrasyon aşamasını gösteriyor.
ORNL, AMD ve HPE ortaklığıyla geliştirilen makine; yüksek başarımlı hesaplama, model eğitimi ve çıkarım işlerini aynı araştırma ortamında buluşturuyor. Geleneksel bir simülasyon fiziksel kuralları çözerek veri üretirken, bir yapay zekâ modeli bu verideki örüntülerden yararlanabiliyor. Bu iki yaklaşımın birlikte kullanılabilmesi, araştırmacının her sorunu yalnızca tek yöntemle çözmek zorunda kalmamasını sağlıyor.
Örneğin bir malzemenin binlerce olası bileşimini değerlendiren ekip düşünün. Her aday için en pahalı simülasyonu çalıştırmak yerine, önce bir modelle umut veren seçenekleri belirleyebilir. Sonra ayrıntılı hesaplamayı daha dar bir aday grubuna uygulayabilir. Bu, Lux için açıklanmış bir hızlanma oranı değil; yapay zekâ ile simülasyonun neden aynı merkezde bir araya getirildiğini açıklayan pratik bir senaryo.
504 düğüm, 4.032 GPU: donanımın iç yapısı
Lux’un temelini HPE ProLiant XD685 hesaplama düğümleri oluşturuyor. “Düğüm” burada kümenin içindeki bağımsız bir sunucu birimini ifade ediyor. Sistemde toplam 504 düğüm ve 4.032 AMD Instinct MI355X GPU bulunuyor. Her düğümde iki adet 64 çekirdekli AMD EPYC 9575F işlemci, 3 TB DDR5 sistem belleği ve sekiz MI355X yer alıyor.
| Bileşen | Lux yapılandırması |
|---|---|
| Hesaplama düğümü | 504 adet HPE ProLiant XD685 |
| Toplam GPU | 4.032 adet AMD Instinct MI355X |
| Düğüm başına CPU | 2 × 64 çekirdekli EPYC 9575F |
| Düğüm başına RAM | 3 TB DDR5 |
| GPU başına bellek | 288 GB HBM3E |
| Yerel depolama | Düğüm başına 8 × 3,2 TB NVMe SSD |
| İş yönetimi | Slurm ve Kubernetes bölümleri |
Bu tabloyu okurken sistem belleği ile GPU belleğini ayırmak gerekiyor. DDR5, işlemcilerin kullandığı ana bellek; HBM3E ise hızlandırıcılara yakın konumlanan yüksek bant genişlikli bellek. İkisi aynı görev için ayrılmış tek bir havuz gibi düşünülmemeli. Bir uygulamanın bu kaynakları verimli kullanabilmesi, veriyi nerede tuttuğuna ve işlemcilerle GPU’lar arasında ne sıklıkta taşıdığına bağlı.
Sunucu tarafındaki bu ayrımı daha küçük ölçekli bir ürün üzerinden görmek isteyenler için HPE ProLiant DL525 Gen13 ön incelemesi, farklı bir HPE platformunun hangi ihtiyaçlara yöneldiğini açıklıyor. Lux’un XD685 tabanlı GPU kümesiyle bir kurumsal sunucuyu değerlendirirken aynı ölçütlerin her zaman geçerli olmayacağını akılda tutmak gerekiyor.
Bellek kapasitesi neden GPU sayısı kadar önemli?
GPU sayısını artırmak, büyük bir modelin otomatik olarak rahat çalışacağı anlamına gelmiyor. Model ağırlıkları, ara hesaplama sonuçları ve kullanılan yönteme bağlı ek veriler bellekte yer kaplıyor. İş yükü tek hızlandırıcıya sığmadığında, geliştiricinin işi bölmesi ve parçalar arasındaki iletişimi düzenlemesi gerekiyor. Bu nedenle Lux’ta GPU başına sunulan 288 GB bellek, yalnızca teknik özellik tablosundaki büyük bir sayı değil.
Basit bir örnek verelim: Bir araştırma ekibinin kullandığı veri yapısı küçük bir GPU’nun belleğine sığmıyorsa, sürekli parça yüklemek ya da daha fazla cihaz arasında paylaşmak gerekebilir. Daha geniş bellek, bazı işlerde bu zorunluluğu azaltabilir. Ancak uygulamanın gerçek ihtiyacı bilinmeden “şu büyüklükteki her model tek GPU’da çalışır” demek doğru olmaz. Sayısal hassasiyet, eğitim yöntemi ve ek bellek tüketimi sonucu değiştirir.
Buradan çıkarılabilecek pratik ders, GPU satın alırken yalnızca işlem gücüne bakmamak. Aynı yaklaşım çok daha küçük araştırma kümeleri için de geçerli: İş yükü belleğe sığıyor mu, veri zamanında geliyor mu, cihazlar birbirini ne kadar bekliyor? Bu sorular yanıtlanmadan kâğıt üzerindeki yüksek kapasitenin uygulamaya ne ölçüde yansıyacağını anlamak zor.
220,79 petaflops ile 40 exaflops aynı şeyi anlatmıyor
Lux’un tanıtımında birden fazla performans değeri var. TOP500’e girişte bildirilen 220,79 petaflops, ölçülmüş sıralama sonucu. Sistem özelliklerinde ayrıca FP64 için 317 petaflops, FP8 yapay zekâ eğitimi için 20 exaflops ve FP4 çıkarım için 40 exaflops düzeyinde kapasite veriliyor. Bunları aynı testin farklı sonuçları gibi karşılaştırmak yanıltıcı olur.
TOP500’ün kullandığı LINPACK yaklaşımı, yoğun bir doğrusal denklem sistemini çözme performansına dayanıyor. Bu ölçüm, makineleri belirli bir görev üzerinde karşılaştırmak için yararlı; fakat her bilimsel uygulamanın veya her yapay zekâ modelinin hızını tek başına temsil etmiyor. Bir sistemin sıralamada önde olması, bütün yazılımlarda aynı oranda avantaj sağlayacağı anlamına gelmiyor.
FP64, FP8 ve FP4 ifadeleri ise hesaplamalarda kullanılan sayı biçimlerini ayırıyor. Sayısal hassasiyet değiştikçe yapılabilen işlem miktarı ve uygun kullanım alanları da değişiyor. Bu nedenle 40 exaflops ifadesini görüp Lux’u FP64 ölçümünde 40 exaflops üreten bir sistem olarak tanımlamıyoruz. Başlıktaki büyük sayının hangi işlem türüne ait olduğu, sayının kendisi kadar önemli.
Bir kurum kendi uygulaması için benzer bir sistemi değerlendiriyorsa gerçekçi karşılaştırma, kendi veri kümesi ve doğruluk hedefiyle yapılmalı. Eğitim süresi, sonuç kalitesi, veri hazırlama maliyeti ve tamamlanan iş başına kaynak tüketimi birlikte incelenmeli. Lux hakkında açıklanan değerler kapasiteyi anlatıyor; henüz yayımlanmamış uygulama testlerinin yerine geçmiyor.
Slurm ve Kubernetes neden birlikte kullanılıyor?
Büyük bir hesaplama kümesinde donanımı paylaşmak başlı başına bir problem. Bir ekip uzun süren bir simülasyon için yüzlerce düğüm isterken, başka bir ekip sürekli yanıt veren bir model hizmeti çalıştırmak isteyebilir. İşlerin ne zaman başlayacağı, ne kadar kaynak kullanacağı ve tamamlandığında kaynakların nasıl geri verileceği düzenlenmeden güçlü sunucular verimli bir araştırma hizmetine dönüşmez.
Slurm, kümedeki kaynakları belirli süreler için işlere ayıran ve bekleyen işleri kuyrukta yöneten bir sistem. Araştırmacının “şu kadar düğümle bu hesabı çalıştır” dediği toplu hesaplama düzeninde kullanılıyor. Kubernetes ise konteyner tabanlı uygulamaların dağıtımı ve çalışır durumda tutulması gibi ihtiyaçlara odaklanıyor. Birbirinden farklı iş biçimlerini destekleyebilmeleri, Lux’un kullanım alanını genişletiyor.
Örnek bir çalışma düzeninde simülasyon tamamlanır, sonuçlar işlenir ve ardından eğitilmiş bir model bu verileri değerlendirir. Bazı adımlar belli bir süre çalışan işlerken, bazıları tekrar tekrar erişilen hizmetler olabilir. Böyle bir akışı tasarlarken araştırmacı yalnızca hesaplama kodunu değil, parçaların birbirine nasıl veri aktaracağını da düşünmek zorunda. İki yönetim ortamının bulunması bu ihtiyaca cevap verebilecek araçlar sağlıyor; bütün entegrasyonu kendiliğinden tamamlamıyor.
Veriyi GPU’ya yetiştirmek de tasarımın bir parçası
Lux’ta her düğümün yerel NVMe depolamasına ek olarak OLCF’nin Orion paralel dosya sistemi kullanılıyor. Yerel SSD ile ortak dosya sistemi aynı ihtiyacı karşılamıyor: Biri hesaplama birimine yakın veri erişimi sunarken, diğeri araştırma ortamında büyük veri kümelerinin paylaşılmasına hizmet ediyor. Çalışmanın hangi aşamasında hangi alanın kullanılacağı bu yüzden önem taşıyor.
Bir modeli eğitirken GPU’nun beklediği veriler depolamadan yeterince hızlı gelmiyorsa, pahalı hesaplama kapasitesi boşta kalabilir. Tersine, bütün veriyi her çalıştırmada gereksiz yere kopyalamak da zaman harcatır. Veriyi hazırlama, taşıma, işleme ve sonuçları saklama adımlarını birlikte planlamak gerekir. Büyük kümelerde yalnızca ana hesaplamayı hızlandırmak, bütün işin aynı oranda hızlanmasını garanti etmez.
Bu yaklaşım güncel sunucu tasarımlarında da görülüyor. İşlemci yoğunluğu ve genişleme seçenekleriyle ilgilenenler, Dell PowerEdge R9815 ve R9825 tanıtımında farklı bir platformun ölçeklenme tercihlerini inceleyebilir. Lux’un verdiği daha genel mesaj ise açık: İşlemci, hızlandırıcı, ağ ve depolama birbirinden kopuk satın alma kalemleri olarak düşünülmemeli.
Hangi araştırmalar Lux’tan yararlanacak?
Açılışta belirtilen çalışma alanları arasında yapay zekâ destekli füzyon santrali tasarımı, malzeme geliştirme ve ileri üretim bulunuyor. Bir başka proje, su mevcudiyeti, akarsu debisi ve nehir sıcaklığını daha uzun vadeli tahmin etmeye odaklanıyor. Bu örnekler, altyapının yalnızca sohbet modelleri için kurulmadığını gösteriyor.
Bu projeleri değerlendirirken hedef ile tamamlanmış sonucu ayırmak gerekiyor. Bir bilgisayarın kullanıma açılması, füzyon enerjisindeki veya malzeme bilimindeki güçlüklerin çözüldüğü anlamına gelmez. Yeni kapasite, araştırmacılara daha çok seçenek deneme ve farklı yöntemleri karşılaştırma imkânı sağlar. Bilimsel sonucun değeri ise deneysel doğrulama, tekrarlanabilirlik ve uygulamanın başarısıyla ortaya çıkar.
Lux için açıklanan yıllık 3,5 milyon düğüm-saatlik kapasitenin yaklaşık yarısı Genesis Mission çalışmalarına, kalan yarısı AMD tarafına ayrılıyor. Düğüm-saat, kaynak kullanımını anlatan bir hesap birimi: Örneğin 10 düğümün iki saat çalışması 20 düğüm-saat eder. Bu miktar, son kullanıcıya sunulan hazır bir hizmetin abonelik süresi gibi okunmamalı.
Sunucu dünyası açısından neden takip edilmeli?
Lux’un açılışı, yapay zekâ altyapısının yalnızca GPU modelinden ibaret olmadığını gösteren güncel bir örnek. Büyük bellek, verinin tutulduğu yer, işlerin planlanması ve bilimsel yazılımın uygun biçimde çalıştırılması aynı tasarımın parçaları. Küçük bir şirketin böyle bir sistemi satın alması gerekmiyor; fakat kendi sunucusunu seçerken aynı soruların daha küçük ölçekteki karşılıklarını sorması gerekiyor.
Bu haberden doğrudan “şu markanın her sunucusu daha hızlı” sonucu da çıkarılamaz. Lux belirli bir kurulum, yazılım ortamı ve araştırma amacı için hazırlanmış bir küme. Masaüstü ekran kartı performansı, oyun deneyimi veya küçük bir işletmenin veritabanı ihtiyacı bu sonuçlardan türetilemez. Anlamlı karşılaştırma, aynı işi benzer koşullarda yapan sistemler arasında yapılır.
Önümüzdeki dönemde Lux’u değerlendirmenin en yararlı yolu, gerçek araştırma uygulamalarından gelecek sonuçlara bakmak olacak. Hangi işin ne kadar sürede tamamlandığı, yazılımın kaç GPU’ya kadar verimli ölçeklendiği ve elde edilen bilimsel çıktılar, açılış rakamlarını somutlaştıracak. Şimdilik doğrulanan gelişme net: 4.032 GPU’lu sistem bilimsel kullanıma açıldı ve ölçülmüş hesaplama performansıyla TOP500’de yerini aldı.